本文是全系列中第23 / 24篇:Pytorch 专栏
- 使用PyTorch建立你的第一个文本分类模型
- PyTorch专栏(十八): 词嵌入,编码形式的词汇语义
- PyTorch 系列教程之空间变换器网络
- PyTorch高级实战教程: 基于BI-LSTM CRF实现命名实体识别和中文分词
- PyTorch专栏(十七): 使用PyTorch进行深度学习
- PyTorch ImageNet 基于预训练六大常用图片分类模型的实战
- 从零开始学PyTorch:一文学会线性回归、逻辑回归及图像分类
- PyTorch专栏(十六):使用字符级RNN进行名字分类
- PyTorch专栏(八):微调基于torchvision 0.3的目标检测模型
- PyTorch 60 分钟入门教程:数据并行处理
- 手把手带你使用字符级RNN生成名字 | PyTorch
- PyTorch专栏(七):模型保存与加载那些事
- Pytorch入门演练
- 聊天机器人实战教程 | PyTorch专栏
- PyTorch专栏(六): 混合前端的seq2seq模型部署
- Python 实现基于深度强化学习算法实现的一个简单自动驾驶 AI 【PyTorch】
- PyTorch 中使用深度学习(CNN和LSTM)的自动图像描述
- PyTorch专栏(十三):使用ONNX将模型转移至Caffe2和移动端
- PyTorch数据可视化工具Visdom(下)
- PyTorch专栏(二十):高级:制定动态决策和BI-LSTM CRF
- PyTorch专栏(十二):一文综述图像对抗算法
- PyTorch中文版官方教程来啦(附下载)
- PyTorch专栏(十九):序列模型和长短句记忆(LSTM)模型 | 文末开奖
- 使用 PyTorch 进行 风格迁移(Neural-Transfer)
作者 | News
编辑 | 奇予纪
出品 | 磐创AI团队出品
【磐创AI 导读】:查看关于本专栏历史文章,请点击文末[阅读全文]。查看本章历史文章,请点击下方蓝色字体进入相应链接阅读。
专栏目录:
-
聊天机器人教程 -
使用字符级RNN生成名字 -
使用字符级RNN进行名字分类 -
在深度学习和NLP中使用Pytorch (3)序列模型和长短句记忆(LSTM)模型
(4)高级:制定动态决策和BI-LSTM CRF
-
使用Sequence2Sequence网络和注意力进行翻译
-
前馈网络
-
序列模型
-
循环神经网络
 ,该隐状态原则上可以包含序列当前结点之前的任一节点的信息。我们可以使用隐藏状态来预测语言模型中的单词, 词性标签以及其他。
1.Pytorch中的LSTM
在正式学习之前,有几个点要说明一下,Pytorch中 LSTM 的输入形式是一个 3D 的Tensor,每一个维度都有重要的意义,第一个维度就是序列本身,第二个维度是mini-batch中实例的索引,第三个维度是输入元素的索引,我们之前没有接触过mini-batch,所以我们就先忽略它并假设第二维的维度是1。如果要用”The cow jumped”这个句子来运行一个序列模型,那么就应该把它整理成如下的形式:
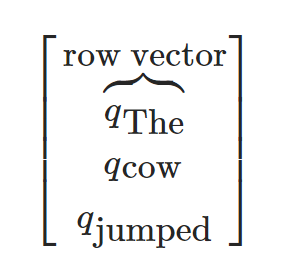
除了有一个额外的大小为1的第二维度。
此外, 你还可以向网络逐个输入序列, 在这种情况下, 第一个轴的大小也是1。
来看一个简单的例子。
# Author: Robert Guthrie
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
torch.manual_seed(1)
lstm = nn.LSTM(3, 3) # 输入维度为3维,输出维度为3维
inputs = [torch.randn(1, 3) for _ in range(5)] # 生成一个长度为5的序列
# 初始化隐藏状态.
hidden = (torch.randn(1, 1, 3),
torch.randn(1, 1, 3))
for i in inputs:
# 将序列中的元素逐个输入到LSTM.
# 经过每步操作,hidden 的值包含了隐藏状态的信息.
out, hidden = lstm(i.view(1, 1, -1), hidden)
# 另外我们可以对一整个序列进行训练.
# LSTM第一个返回的第一个值是所有时刻的隐藏状态
# 第二个返回值是最后一个时刻的隐藏状态
#(所以"out"的最后一个和"hidden"是一样的)
# 之所以这样设计:
# 通过"out"你能取得任何一个时刻的隐藏状态,而"hidden"的值是用来进行序列的反向传播运算, 具体方式就是将它作为参数传入后面的 LSTM 网络.
# 增加额外的第二个维度.
inputs = torch.cat(inputs).view(len(inputs), 1, -1)
hidden = (torch.randn(1, 1, 3), torch.randn(1, 1, 3)) # 清空隐藏状态.
out, hidden = lstm(inputs, hidden)
print(out)
print(hidden)
-
输出结果:
tensor([[[-0.0187, 0.1713, -0.2944]],
[[-0.3521, 0.1026, -0.2971]],
[[-0.3191, 0.0781, -0.1957]],
[[-0.1634, 0.0941, -0.1637]],
[[-0.3368, 0.0959, -0.0538]]], grad_fn=<StackBackward>)
(tensor([[[-0.3368, 0.0959, -0.0538]]], grad_fn=<StackBackward>), tensor([[[-0.9825, 0.4715, -0.0633]]], grad_fn=<StackBackward>))
2.例子:用LSTM来进行词性标注
在这部分, 我们将会使用一个 LSTM 网络来进行词性标注。在这里我们不会用到维特比算法, 前向-后向算法或者任何类似的算法,而是将这部分内容作为一个 (有挑战) 的练习留给读者, 希望读者在了解了这部分的内容后能够实现如何将维特比算法应用到 LSTM 网络中来。
 ,其中
 ,标签的集合定义为 T,
 为单词
 的标签,用
 表示对单词
 词性的预测。
 , 其中
 。
 ,同样地, 对每个标签赋一个独一无二的索引 (类似 word embeddings 部分 word_to_ix 的设置). 然后就得到了
 的预测规则:
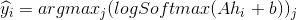
2.1 准备数据
def prepare_sequence(seq, to_ix):
idxs = [to_ix[w] for w in seq]
return torch.tensor(idxs, dtype=torch.long)
training_data = [
("The dog ate the apple".split(), ["DET", "NN", "V", "DET", "NN"]),
("Everybody read that book".split(), ["NN", "V", "DET", "NN"])
]
word_to_ix = {}
for sent, tags in training_data:
for word in sent:
if word not in word_to_ix:
word_to_ix[word] = len(word_to_ix)
print(word_to_ix)
tag_to_ix = {"DET": 0, "NN": 1, "V": 2}
# 实际中通常使用更大的维度如32维, 64维.
# 这里我们使用小的维度, 为了方便查看训练过程中权重的变化.
EMBEDDING_DIM = 6
HIDDEN_DIM = 6
-
输出结果:
{'The': 0, 'dog': 1, 'ate': 2, 'the': 3, 'apple': 4, 'Everybody': 5, 'read': 6, 'that': 7, 'book': 8}
2.2 创建模型
class LSTMTagger(nn.Module):
    def __init__(self, embedding_dim, hidden_dim, vocab_size, tagset_size):        super(LSTMTagger, self).__init__()        self.hidden_dim = hidden_dim
        self.word_embeddings = nn.Embedding(vocab_size, embedding_dim)
        # LSTM以word_embeddings作为输入, 输出维度为 hidden_dim 的隐藏状态值        self.lstm = nn.LSTM(embedding_dim, hidden_dim)
        # 线性层将隐藏状态空间映射到标注空间        self.hidden2tag = nn.Linear(hidden_dim, tagset_size)        self.hidden = self.init_hidden()
    def init_hidden(self):        # 一开始并没有隐藏状态所以我们要先初始化一个        # 关于维度为什么这么设计请参考Pytoch相关文档        # 各个维度的含义是 (num_layers, minibatch_size, hidden_dim)        return (torch.zeros(1, 1, self.hidden_dim),                torch.zeros(1, 1, self.hidden_dim))
    def forward(self, sentence):        embeds = self.word_embeddings(sentence)        lstm_out, self.hidden = self.lstm(            embeds.view(len(sentence), 1, -1), self.hidden)        tag_space = self.hidden2tag(lstm_out.view(len(sentence), -1))        tag_scores = F.log_softmax(tag_space, dim=1)        return tag_scores
2.3 训练模型
model = LSTMTagger(EMBEDDING_DIM, HIDDEN_DIM, len(word_to_ix), len(tag_to_ix))
loss_function = nn.NLLLoss()
optimizer = optim.SGD(model.parameters(), lr=0.1)
# 查看训练前的分数
# 注意: 输出的 i,j 元素的值表示单词 i 的 j 标签的得分
# 这里我们不需要训练不需要求导,所以使用torch.no_grad()
with torch.no_grad():
inputs = prepare_sequence(training_data[0][0], word_to_ix)
tag_scores = model(inputs)
print(tag_scores)
for epoch in range(300): # 实际情况下你不会训练300个周期, 此例中我们只是随便设了一个值
for sentence, tags in training_data:
# 第一步: 请记住Pytorch会累加梯度.
# 我们需要在训练每个实例前清空梯度
model.zero_grad()
# 此外还需要清空 LSTM 的隐状态,
# 将其从上个实例的历史中分离出来.
model.hidden = model.init_hidden()
# 准备网络输入, 将其变为词索引的 Tensor 类型数据
sentence_in = prepare_sequence(sentence, word_to_ix)
targets = prepare_sequence(tags, tag_to_ix)
# 第三步: 前向传播.
tag_scores = model(sentence_in)
# 第四步: 计算损失和梯度值, 通过调用 optimizer.step() 来更新梯度
loss